Kubernetes verbinden
Legen Sie einen Cluster an, installieren Sie den Costfluent-Agenten mit Helm und dem Cluster-Token darin und sehen Sie seine Kosten nach Cluster, Namespace und Label.
Costfluent verteilt die Kosten der Nodes eines Kubernetes-Clusters auf Namespaces und weist den verbleibenden Leerlauf getrennt aus. Eine verifizierte Kostenansicht pro Pod, Workload oder Container gibt es nicht. Ein kleiner Agent, mit Helm installiert, liest die Ressourcennutzung im Cluster und meldet sie stündlich an Costfluent. Sie legen den Cluster zuerst an, unter Einstellungen, dann Integrationen, dann Kubernetes, im Tab Verbinden, und der Agent meldet mit dem Token dieses Clusters.
Wie Costfluent verbindet
Der Agent liest nur: Nodes, Pods, Persistent Volumes und Storage-Klassen, die ReplicaSets und Jobs, denen Pods gehören, die Ressourcenmetriken, die jedes Kubelet bereitstellt, und, nur wenn Sie es erlauben, Namespaces und Persistent Volume Claims. Die Kubelet-Metriken liest er mit dem Token eines zweiten Dienstkontos, das nur Node-Metriken lesen kann: Der Agent darf nur für dieses Konto ein Token erstellen, fordert jeweils eines an, das eine Stunde gilt, und gibt sein eigenes Token nie an ein Kubelet. Er sendet Cluster-ID, Agentenversion, zufällige Instanz-ID und Zeitfenster jedes Berichts, Form, Identität, Labels und GPUs der Nodes, die unten beschriebenen Annotationen der Nodes und Storage-Klassen, Identität von Pods und Containern, Ressourcenanforderungen und -nutzung, wie viele Nodes er nicht lesen konnte und warum, alle Pod-Labels, sofern Sie sie nicht einschränken, die Pod-Annotationen, die Sie erlauben, Namespace- und Claim-Labels, wenn Sie es erlauben, die Claims, die jeder Pod einbindet, und von jedem Persistent Volume Größe, Storage-Klasse, Treiber, Phase, Claim und, bei einer Disk von AWS, Azure oder GCP, die ID der Disk. Container-Images, Umgebungsvariablen, Secrets, Config Maps, Volume-Inhalte, Logs und Netzwerkverkehr sendet er nie. Die Tabelle what the agent reads and sends in der README des Charts ist die vollständige Liste.
Berichte, die nicht zugestellt werden können, bleiben bis zu 96 Stunden und 50 MB auf dem Volume des Agenten und werden gesendet, sobald Costfluent wieder erreichbar ist. Ein Tag, für den nach seiner Verarbeitung noch Berichte eintreffen, wird noch einmal aus allen seinen Berichten verarbeitet: spätestens in der dritten Nacht nach dem Tag oder, falls das später ist, spätestens in der Nacht nach dem Eintreffen der Berichte.
Voraussetzungen
- Ein Kubernetes-Cluster, in dem Sie ein Helm-Chart installieren können, mit clusterweitem Lesezugriff für das Dienstkonto des Agenten.
- Eine Standard-StorageClass für das 1-GiB-Volume des Agenten, oder Sie installieren mit
persist=null(Wichtige Werte). - Ausgehendes HTTPS vom Cluster zu
https://api.costfluent.com, direkt oder über einen Proxy. - Die Organisationsrolle Eigentümer oder Integrationsverantwortliche Person in Costfluent, die Rollen, die Datenquellen verwalten.
Verbinden
Den Agenten installieren
Der Tab Verbinden auf der Seite Kubernetes enthält dieselben Schritte mit Befehlen zum Kopieren, ebenso der Schritt Verbinden des Onboardings, wenn Sie Kubernetes wählen (Schnellstart).
-
Wählen Sie im Tab Verbinden den Eintrag Cluster anlegen und geben Sie eine Cluster-ID an. Die ID kennzeichnet den Cluster in Costfluent und muss innerhalb Ihrer Organisation eindeutig sein: 1 bis 63 Buchstaben, Ziffern, Punkte, Unterstriche oder Bindestriche, beginnend mit einem Buchstaben oder einer Ziffer. Sie ist später nicht änderbar, da Kostenberichte die Kosten des Clusters danach gruppieren. Ein Anzeigename ist optional: Er benennt die Verbindung des Clusters überall, wo Costfluent sie zeigt, und ohne ihn tut das die Cluster-ID. Umbenennen, im Zeilenmenü des Clusters oder auf seiner Seite, ändert ihn später. Umbenennen verlangt einen Namen: Um die Verbindung wieder nach der Cluster-ID zu benennen, geben Sie die Cluster-ID ein. Eine Organisation hat höchstens 100 Cluster.
-
Costfluent zeigt das Cluster-Token einmal an, zusammen mit dem Installationsbefehl, der es enthält. Das Token meldet die Nutzung dieses Clusters und sonst nichts: Es kann keinen anderen Cluster melden und keine Daten lesen. Kopieren Sie es jetzt.
-
Lesen Sie das Token in
COSTFLUENT_CLUSTER_TOKENein: Fügen Sie es an der stillen Eingabe ein und drücken Sie die Eingabetaste, damit es nie in einer Befehlszeile oder Ihrem Shell-Verlauf steht. Installieren Sie dann das Chart:Code
Ein Cluster-Token funktioniert in jedem Tarif. Neues Token im Zeilenmenü eines Clusters stellt ein weiteres Token für ihn aus, für eine neue Installation oder als Ersatz für eines, das durchgesickert ist; widerrufen Sie das alte unter Einstellungen, dann API-Token.
Installieren Sie einen Agenten pro Cluster. Der Cluster erscheint als Ausstehend, bis der erste Bericht eintrifft, wenige Minuten nach dem Start des Agenten, und danach als Import läuft. Ein neuer Cluster speist noch keinen Workspace: Der Token-Dialog endet mit Workspaces auswählen, das die Seite des Clusters öffnet. Dort wählen Sie die Workspaces, die seine Kosten sehen sollen, wie der Abschnitt nach Dimensionierung zeigt. Ein im Tab Verbinden angelegter Cluster öffnet diese Seite auch, wenn Sie den Token-Dialog schließen.
Der Installationsbefehl der Konsole fragt zuerst, wo der Cluster läuft, und ergänzt, was dieser
Cluster braucht: auf AKS agent.nodeAddressTypes=InternalIP, weil seine Kubelets unter ihrer
Standardadresse oft nicht erreichbar sind; auf OpenShift podSecurityContext.runAsUser,
runAsGroup und fsGroup auf null, damit OpenShift die eigenen Benutzer-IDs des Namespace
vergibt; und für Talos, kubeadm oder kind agent.disableKubeTLSverify=true
(Kubelet-Zertifikate). Für EKS, GKE, k3s, RKE2 und andere Cluster ergänzt er
nichts und lässt die Prüfung der Kubelet-Zertifikate eingeschaltet. Kann der Agent die Kubelets
einiger Nodes nicht lesen, wechselt der Cluster nach seinem ersten Bericht auf Warnung, und seine
Karte Cluster-Zustand nennt die Lösung (Häufige Fehler). Ein Cluster ohne Cloud-Rechnung braucht außerdem
Node-Raten, bevor seine Nutzung bepreist wird.
Wichtige Werte
| Wert | Standard | Zweck |
|---|---|---|
agent.token | keiner | Das Cluster-Token. Setzen Sie es oder agent.secret. |
agent.secret.name, agent.secret.key | keiner, token | Ein vorhandenes Secret mit dem Token und der Schlüssel darin, statt agent.token. |
agent.clusterID | der Cluster des Tokens | Optional. Ist sie gesetzt, startet der Agent nur, wenn sie der Cluster des Tokens ist. |
agent.apiEndpoint | https://api.costfluent.com | Wohin die Berichte gehen. |
agent.pollingInterval | 60 | Sekunden zwischen zwei Nutzungsmessungen: 5, 10, 15, 30 oder 60. |
agent.nodeAddressTypes | InternalIP,InternalDNS,Hostname,ExternalIP,ExternalDNS | Welche Node-Adressen der Agent der Reihe nach versucht, um jedes Kubelet zu erreichen. |
agent.disableKubeTLSverify | false | Kubelet-Zertifikate nicht prüfen. |
agent.allowedLabels | alle | Zu sendende Pod-Labels. Leer sendet alle Pod-Labels. |
agent.allowedAnnotations | keine | Zu sendende Pod-Annotationen, höchstens 10. Leer sendet keine. |
agent.collectNamespaceLabels | false | Namespace-Labels senden. |
agent.collectPVCLabels | false | Die Claim-Labels jedes gebundenen Volumes senden; dafür darf der Agent Persistent Volume Claims auflisten. |
agent.reportHTTPProxy | keiner | Ein HTTP-Proxy für den Upload, ohne Zugangsdaten. |
agent.reportHTTPProxySecret.name, agent.reportHTTPProxySecret.key | keiner, keiner | Ein vorhandenes Secret und der Schlüssel darin mit der URL des Upload-Proxys samt Zugangsdaten, statt agent.reportHTTPProxy. |
agent.reportCABundle.configMap, agent.reportCABundle.secret, agent.reportCABundle.key | keiner, keiner, ca.crt | Eine vorhandene ConfigMap oder ein vorhandenes Secret, nur eines von beiden, und der Schlüssel darin mit PEM-Zertifikaten, denen der Agent für den Upload vertraut, für einen Proxy, der TLS neu signiert. |
agent.logLevel | info | Wie viel der Agent protokolliert. |
persist | ein Volume-Claim | null hält den Puffer stattdessen in einem emptyDir, für einen Cluster ohne StorageClass; er geht verloren, wenn der Pod neu eingeplant wird. |
persist.size | 1Gi | Das Volume, das Berichte puffert, solange Costfluent nicht erreichbar ist. |
persist.storageClassName | die Standardklasse des Clusters | Die Storage-Klasse dieses Volumes. |
resources | Anforderung 50m CPU und 64Mi, Limit 256Mi | CPU- und Speicheranforderungen und -limits des Agenten. |
Halten Sie das Token aus Values-Dateien in der Versionskontrolle heraus: Legen Sie es in einem Secret ab und
verweisen Sie mit agent.secret darauf.
Kubelet-Zertifikate
Der Agent liest die Nutzung jedes Nodes von dessen Kubelet auf Port 10250 und prüft das Serving-Zertifikat des Kubelets. Der Befehl der Konsole lässt die Prüfung für EKS, GKE, k3s, RKE2 und andere Cluster eingeschaltet, und die Kubelets von k3s bestehen sie. Kubelets von Talos, kubeadm und kind liefern standardmäßig selbstsignierte Zertifikate, und jedes Lesen schlägt fehl, bis eines davon zutrifft:
- Die Kubelets liefern Zertifikate, die die Cluster-CA signiert, und die Prüfung bleibt
eingeschaltet. Auf kubeadm setzen Sie
serverTLSBootstrap: truein der Kubelet-Konfiguration und genehmigen die Certificate Signing Requests der Kubelets; auf Talos setzen Sie das Argumentrotate-server-certificatesdes Kubelets auftrueund betreiben einen Genehmiger für diese Anfragen. Das ist die sichere Lösung. - Der Agent überspringt die Prüfung mit
agent.disableKubeTLSverify=true, das der Befehl der Konsole für Talos, kubeadm oder kind setzt. Was dann auf Port 10250 eines Nodes antwortet, gilt als vertrauenswürdig: Es erhält das Kubelet-Token des Agenten, das Node-Metriken lesen kann und sonst nichts, und könnte dem Agenten falsche Nutzung liefern.
Das Kubelet-Token schützt nur Kubelets, die es prüfen. Ein Kubelet, dessen Webhook-Authentifizierung ausgeschaltet ist und das anonyme Anfragen zulässt, liefert seine Metriken jedem Aufrufer, der Port 10250 erreicht, mit oder ohne Agent; dieses Risiko liegt beim Cluster selbst, und keine Einstellung des Agenten ändert es.
GitOps mit Argo CD oder Flux
Argo CD oder Flux können den Agenten aus dem Chart-Repository installieren. Das Token kommt in ein
Secret, das agent.secret.name und agent.secret.key nennen, sodass kein Manifest in Ihrem
Repository es enthält. Der Tab Verbinden und der Token-Dialog bieten GitOps neben Helm
an: Sobald Sie wählen, wo der Cluster läuft, zeigen sie den Befehl für das Secret und beide
Manifeste, mit den Werten, die dieser Cluster braucht, und der neuesten Chart-Version.
-
Lesen Sie mit dem Cluster als aktuellem kubectl-Kontext das Token an der stillen Abfrage ein und legen Sie es in einem Secret im Namespace des Agenten ab. Die Zeile für den Namespace schlägt folgenlos fehl, wenn er schon existiert.
Code -
Committen Sie ein Manifest in das Repository, das Ihr Controller synchronisiert. Für Argo CD eine
Applicationim Namespace, in dem Argo CD läuft, die wie Ihre anderen Applications synchronisiert wird, von Hand oder automatisch:CodeFür Flux ein
HelmRepositoryund einHelmReleaseim Namespace des Agenten:Code
Beide installieren das Release als cfa im Namespace costfluent, wie der Installationsbefehl, daher
sind die Namen und Labels, die die kubectl-Befehle dieser Seite verwenden, dieselben. Ergänzen Sie
unter den Werten, was der Installationsbefehl der Konsole dafür setzt, wo der Cluster läuft
(Den Agenten installieren), etwa agent.nodeAddressTypes auf AKS.
Die helm-Befehle dieser Seite funktionieren bei einer GitOps-Installation nicht. Argo CD rendert das
Chart und wendet an, was es rendert, daher hält der Cluster kein Helm-Release, und helm upgrade oder
helm uninstall von cfa findet keines. Flux führt ein Helm-Release, setzt es beim nächsten Abgleich
aber auf das HelmRelease zurück, daher hält ein von Hand gesetzter Wert nicht. Ändern Sie die
Installation über ihr Manifest:
-
Ein Wert. Setzen Sie ihn unter
valuesObjectodervaluesund committen Sie ihn. Eine Lösung, die die Karte Cluster-Zustand oder diese Seite als--set key=valueangibt, gehört ebenfalls dorthin, alskey: valueunter seinen übergeordneten Schlüsseln. -
Aktualisieren. Jedes Manifest pinnt genau eine Chart-Version, nie einen Bereich, daher erreicht ein neues Chart den Cluster erst, wenn Sie es setzen. Die Beispiele pinnen das Chart, das diese Seite beschreibt; die Manifeste der Konsole pinnen das neueste. Setzen Sie
targetRevisionoderversionauf die Chart-Version, die Agenten aktualisieren im Tab Verwalten nennt, und committen Sie sie. -
Token. Das Token liegt im Secret
costfluent-token, das keiner der beiden Controller verwaltet: Ersetzen Sie es und starten Sie den Agenten neu, mit denagent.secret-Befehlen aus Das Token rotieren. -
Trennen. Bei Argo CD entfernen Sie die
Applicationaus Ihrem Repository, damit nichts sie neu anlegt, und löschen sie samt ihren Ressourcen:argocd app delete costfluent-agent. Einkubectl deletederApplicationentfernt den Agenten nur, wenn die Application den Finalizerresources-finalizer.argocd.argoproj.ioträgt; ohne ihn läuft der Agent weiter. Bei Flux entfernen Sie dasHelmReleaseund dasHelmRepositoryaus Ihrem Repository: Flux löscht sie, wo seine Kustomization bereinigt (Prune), sonst tut eskubectl -n costfluent delete helmrelease costfluent-agent, und das Löschen desHelmReleasedeinstalliert das Release. Löschen Sie danach in beiden Fällen den Claim, den das StatefulSet zurücklässt, und das Secret des Tokens, und entfernen Sie die Verbindung, wie Trennen beschreibt:Code
Flux wartet nach einer Installation, bis der Agent bereit ist, wie es --wait im Installationsbefehl
tut. Argo CD rendert das Chart offline, daher läuft die StorageClass-Prüfung des Charts dort nicht
(Selbst betriebene Cluster).
Private und selbst betriebene Cluster
Der Agent läuft im Cluster. Er braucht DNS, den Kubernetes-API-Server, das Kubelet jedes Nodes auf
Port 10250 und ausgehendes HTTPS zu api.costfluent.com, direkt oder über einen Proxy; Costfluent
verbindet sich nie zu ihm. Ein Cluster, der Costfluent auch über einen Proxy nicht erreicht, lässt
sich nicht verbinden.
Private verwaltete Cluster
Ein EKS-, AKS- oder GKE-Cluster mit privatem API-Endpunkt braucht nichts weiter: Der Agent erreicht
den API-Server aus dem Cluster heraus. Die Nodes brauchen ausgehendes HTTPS zu api.costfluent.com,
über ein NAT-Gateway oder einen Proxy (Egress-Proxy). Führen Sie den
Installationsbefehl dort aus, wo kubectl den Cluster erreicht, etwa auf einem Bastion-Host oder
einem Runner in seinem Netz, oder lassen Sie einen GitOps-Controller im Cluster das Chart
installieren, mit dem Token in einem Secret, das agent.secret.name nennt
(GitOps mit Argo CD oder Flux).
Egress-Proxy
Der Agent sendet seinen Verkehr zu Costfluent, seine Berichte und die Prüfung seines Tokens beim
Start, über den Proxy, den Sie nennen, und leitet nie Verkehr zur Kubernetes-API oder zu den Kubelets
darüber. Der Proxy muss dem Agenten einen Tunnel zu api.costfluent.com auf Port 443 öffnen lassen.
Nennen Sie einen Proxy ohne Zugangsdaten in agent.reportHTTPProxy; das Chart lehnt dort eine URL
mit Benutzer oder Passwort ab. Legen Sie eine solche URL deshalb in einem Secret ab und nennen Sie es
in agent.reportHTTPProxySecret:
Code
Ein Proxy, der TLS prüft, signiert das Zertifikat von Costfluent mit seiner eigenen CA neu, der der
Agent standardmäßig nicht vertraut. Legen Sie die PEM-Zertifikate dieser CA in einer ConfigMap ab,
oder mit kubectl create secret generic in einem Secret, und nennen Sie sie in
agent.reportCABundle. Der Agent vertraut ihnen neben den öffentlichen CAs, nur für seinen Verkehr
zu Costfluent, nie für den Kubernetes-API-Server oder die Kubelets:
Code
Installieren Sie dann mit den Werten des Proxys neben dem Token, hier ein Proxy mit Zugangsdaten und seiner CA:
Code
Ein Proxy ohne Zugangsdaten nimmt statt der beiden Zeilen agent.reportHTTPProxySecret
--set agent.reportHTTPProxy=http://proxy.internal:3128, und eine CA in einem Secret nimmt
agent.reportCABundle.secret statt agent.reportCABundle.configMap. Der Schlüssel darin ist in
beiden Fällen standardmäßig ca.crt; setzen Sie agent.reportCABundle.key für einen anderen.
Default-Deny-Egress
Wo eine NetworkPolicy ausgehenden Verkehr standardmäßig sperrt, erlauben Sie dem Pod des Agenten diese Verbindungen:
- DNS, zum DNS-Dienst des Clusters.
- Den Kubernetes-API-Server, unter der Adresse und dem Port, die seine Endpunkte nennen (
kubectl get endpointslices -n default -l kubernetes.io/service-name=kubernetes). - Das Kubelet jedes Nodes, auf Port 10250, unter der Adresse, die
agent.nodeAddressTypeswählt. - Port 443 von
api.costfluent.comoder, wenn der Agent einen Proxy nutzt, Adresse und Port des Proxys.
api.costfluent.com wird über Cloudflare ausgeliefert, seine Adressen sind also geteilt und ändern
sich, und eine IP-Regel kann es nicht benennen. Nutzt der Agent einen Proxy, erlauben Sie nur den
Proxy. Ohne Proxy nutzen Sie die Regel Ihres CNI für einen Domainnamen, unten; nur ein CNI ohne eine
solche Regel lässt Port 443 zu jeder Adresse offen. Dieses Beispiel für das Release cfa erlaubt
einen Proxy; ersetzen Sie die Adressen durch die Ihres Clusters:
Code
Die zweite Regel ist der Endpunkt des API-Servers, die dritte das Node-Netz, auf dem die Kubelets
lauschen, und die letzte der Proxy. Ohne Proxy und ohne Domain-Regel erlaubt die letzte Regel
stattdessen 0.0.0.0/0 auf Port 443.
Die erste Regel passt zu kube-dns- oder CoreDNS-Pods in kube-system, die auf Port 53 lauschen. Zwei
andere DNS-Varianten brauchen an ihrer Stelle eine eigene Regel. NodeLocal DNSCache antwortet auf
jedem Node selbst, unter seiner lokalen Adresse und im iptables-Modus auch unter der Adresse des
DNS-Service, nicht aus den DNS-Pods; erlauben Sie diese Adressen daher mit einem ipBlock auf Port 53.
Die DNS-Pods von OpenShift laufen im Namespace openshift-dns und lauschen auf Port 5353 hinter
Port 53 des Service; wählen Sie daher diesen Namespace und erlauben Sie UDP und TCP auf Port 5353.
CNIs erfassen den API-Server und die Kubelets, die im eigenen Netz der Nodes lauschen,
unterschiedlich. Die meisten wenden eine NetworkPolicy an, nachdem die Adresse des Service
kubernetes in die des API-Servers übersetzt wurde, sodass eine Regel den Endpunkt nennt, nicht den
Service. Der ipBlock von Cilium erfasst Nodes und den API-Server nur, wenn Cilium mit
--policy-cidr-match-mode=nodes läuft; erlauben Sie sie sonst über seine Entitäten, wie das
Cilium-Beispiel unten. Meldet das Log des Agenten Kubelets oder den API-Server als nicht erreichbar,
nachdem Sie eine Policy angewendet haben, prüfen Sie, wie Ihr CNI sie auswählt.
Auf Cilium benennt eine CiliumNetworkPolicy den API-Host mit toFQDNs. Cilium erfährt seine Adressen
aus den DNS-Antworten, die es prüft, daher erlaubt die Policy DNS auch über ihre DNS-Regel:
Code
Auf Calico Cloud oder Calico Enterprise benennt eine Calico-NetworkPolicy ihn mit
destination.domains, anstelle der letzten Regel der NetworkPolicy; deren DNS-Regel bleibt:
Code
Private Registry
Das Image des Agenten, ghcr.io/costfluent/k8s-agent, wird für amd64 und arm64 gebaut, und das Chart
lädt es über den Digest, den sein Release aufgelöst hat. Spiegeln Sie es mit einer Kopie, die beide
Architekturen und den Digest erhält, etwa mit crane copy oder skopeo copy --all --preserve-digests,
unter dem Tag der appVersion des Charts, die
helm show chart costfluent/costfluent-k8s-agent --version <Chart-Version> für die Chart-Version
zeigt, die der Installationsbefehl unten pinnt:
Code
Installieren Sie dann mit image.repository auf dem Spiegel und, wenn die Registry Zugangsdaten
verlangt, einem vorhandenen Pull-Secret in imagePullSecrets:
Code
Der image.digest des Charts hat Vorrang vor image.tag und passt nur dann noch zum Spiegel, wenn
die Kopie den Digest erhalten hat. Hat die Kopie das Image neu gebaut oder die Registry es
umgeschrieben, setzen Sie image.digest auf den Digest des Spiegels, oder auf "", um über den Tag
zu laden.
OpenShift
Die Standard-Security-Context-Constraint von OpenShift, restricted-v2, gibt jedem Namespace einen
eigenen Bereich von Benutzer-IDs und weist dem Pod eine daraus zu. Das Chart verlangt Benutzer und
Gruppe 1000. Installieren Sie auf OpenShift deshalb ohne diese IDs, was der Befehl der Konsole für
OpenShift ergänzt:
Code
Der Pod läuft weiterhin als ein anderer Benutzer als root, mit dem Standard-Seccomp-Profil der Laufzeit.
Selbst betriebene Cluster
- Kubelet-Zertifikate. Die sichere Lösung sind Serving-Zertifikate der Kubelets, die die
Cluster-CA signiert;
agent.disableKubeTLSverify=truekommt an zweiter Stelle, mit dem, dem es vertraut (Kubelet-Zertifikate). - Node-Adressen. Für jeden Node nimmt der Agent die erste Adresse der Typen, die
agent.nodeAddressTypesder Reihe nach nennt, die der Node hat, und versucht nicht die nächste, wenn er keine Verbindung bekommt. Liegt die erste solche Adresse eines Nodes in einem Netz, das Pods nicht erreichen, nennen Sie den Typ, den sie erreichen, zuerst, etwaagent.nodeAddressTypes=ExternalIP,InternalIP. - Speicher. Der Puffer des Agenten braucht eine StorageClass, die seinen Volume-Claim
bereitstellt: Setzen Sie
persist.storageClassNameoder installieren Sie mitpersist=nullfür ein emptyDir. Argo CD rendert das Chart mithelm template, ohne den Cluster zu lesen, daher läuft die StorageClass-Prüfung der Installation dort nicht, und ein Claim, den keine Klasse bereitstellt, bleibt Pending. - Node-Raten. Nodes, die keine Cloud abrechnet, werden über die Raten bepreist, die Sie hinterlegen (On-Premises und eigene Raten); bis dahin werden sie ausgelassen und als unbepreist gezählt.
Dimensionierung
Der Agent ist ein einzelner Pod, unabhängig von der Größe des Clusters. Sein Speicherbedarf wächst
mit der Zahl der Container, die er verfolgt. Gemessen mit 61 Pods bei einem Abfrageintervall von
5 Sekunden lag sein Working Set im Mittel bei 11,4 MiB, in der Spitze bei 12,8 MiB, bei unter
0,001 CPU-Kernen. Die Standardwerte (64Mi angefordert, 256Mi Limit) lassen Raum für ein
Vielfaches dieser Clustergröße; erhöhen Sie das Speicherlimit, wenn der Pod wegen Überschreitung neu
gestartet wird.
Costfluent erfasst Cluster mit bis zu 1.000 Nodes und 50.000 Pods. Die Berichte eines größeren Clusters werden abgelehnt (siehe 400 unter Häufige Fehler). Persistent Volumes führen nie zur Ablehnung eines Berichts: Über 50.000 hinaus sendet der Agent die ersten nach Name, und ein Pod mit mehr als 32 Claims sendet seine ersten 32.
Ein Cluster-Tag behält bis zu 50.000 Container im Detail. Container, die später am Tag starten, wie die Pods eines CronJobs, werden je Node nach Workload zusammengefasst, danach je Node nach Namespace; darüber hinaus wird die Nutzung eines Containers nicht gezählt und bleibt in den Leerlaufkosten seines Nodes, sodass der Tag die gesamten Kosten seiner Nodes behält. Ein Container oder Node behält bis zu 64 Labels, die ersten nach Schlüssel. Der Cluster zeigt dann Warnung, und die Zeile unter dem Status sagt, was zusammengefasst wurde. Ein Tag mit mehr als 20.000 Node-Instanzen wird nicht verarbeitet, und die Zeile unter dem Status sagt, warum. Ein Cluster-Tag behält bis zu 1.440 Berichte, die ein Agent nur erreicht, wenn er an diesem Tag Hunderte Male neu startet; darüber hinaus wird ein neues Zeitfenster dieses Tages abgelehnt (siehe 409 unter Häufige Fehler), ein Zeitfenster, das der Tag schon hält, wird erneut angenommen, und der Tag wird mit den Berichten verarbeitet, die er behält. Ein Tag bepreist bis zu 25.000 Persistent Volumes und hält 50.000 Einbindungen eines Claims durch Pods getrennt; darüber hinaus werden die Einbindungen eines Pods mit denen seines Workloads gezählt und danach dem Namespace des Claims überlassen, und ein Volume über der Grenze wird nicht gezählt, was die Zeile unter dem Status ebenfalls sagt.
Die Cluster einer Organisation senden zusammen höchstens 1 GiB komprimierte Berichte pro UTC-Tag, jeder Bericht gezählt an dem Tag, an dem er ankommt. Darüber hinaus wird ein Bericht bis Mitternacht UTC abgelehnt (siehe 429 unter Häufige Fehler). Der Agent behält den abgelehnten Bericht und die danach und sendet ihn spätestens alle 15 Minuten erneut, sodass sie bald nach Mitternacht ankommen, es sei denn, der Puffer des Agenten läuft vorher voll und verwirft seine ältesten Berichte.
Festlegen, welche Workspaces einen Cluster sehen
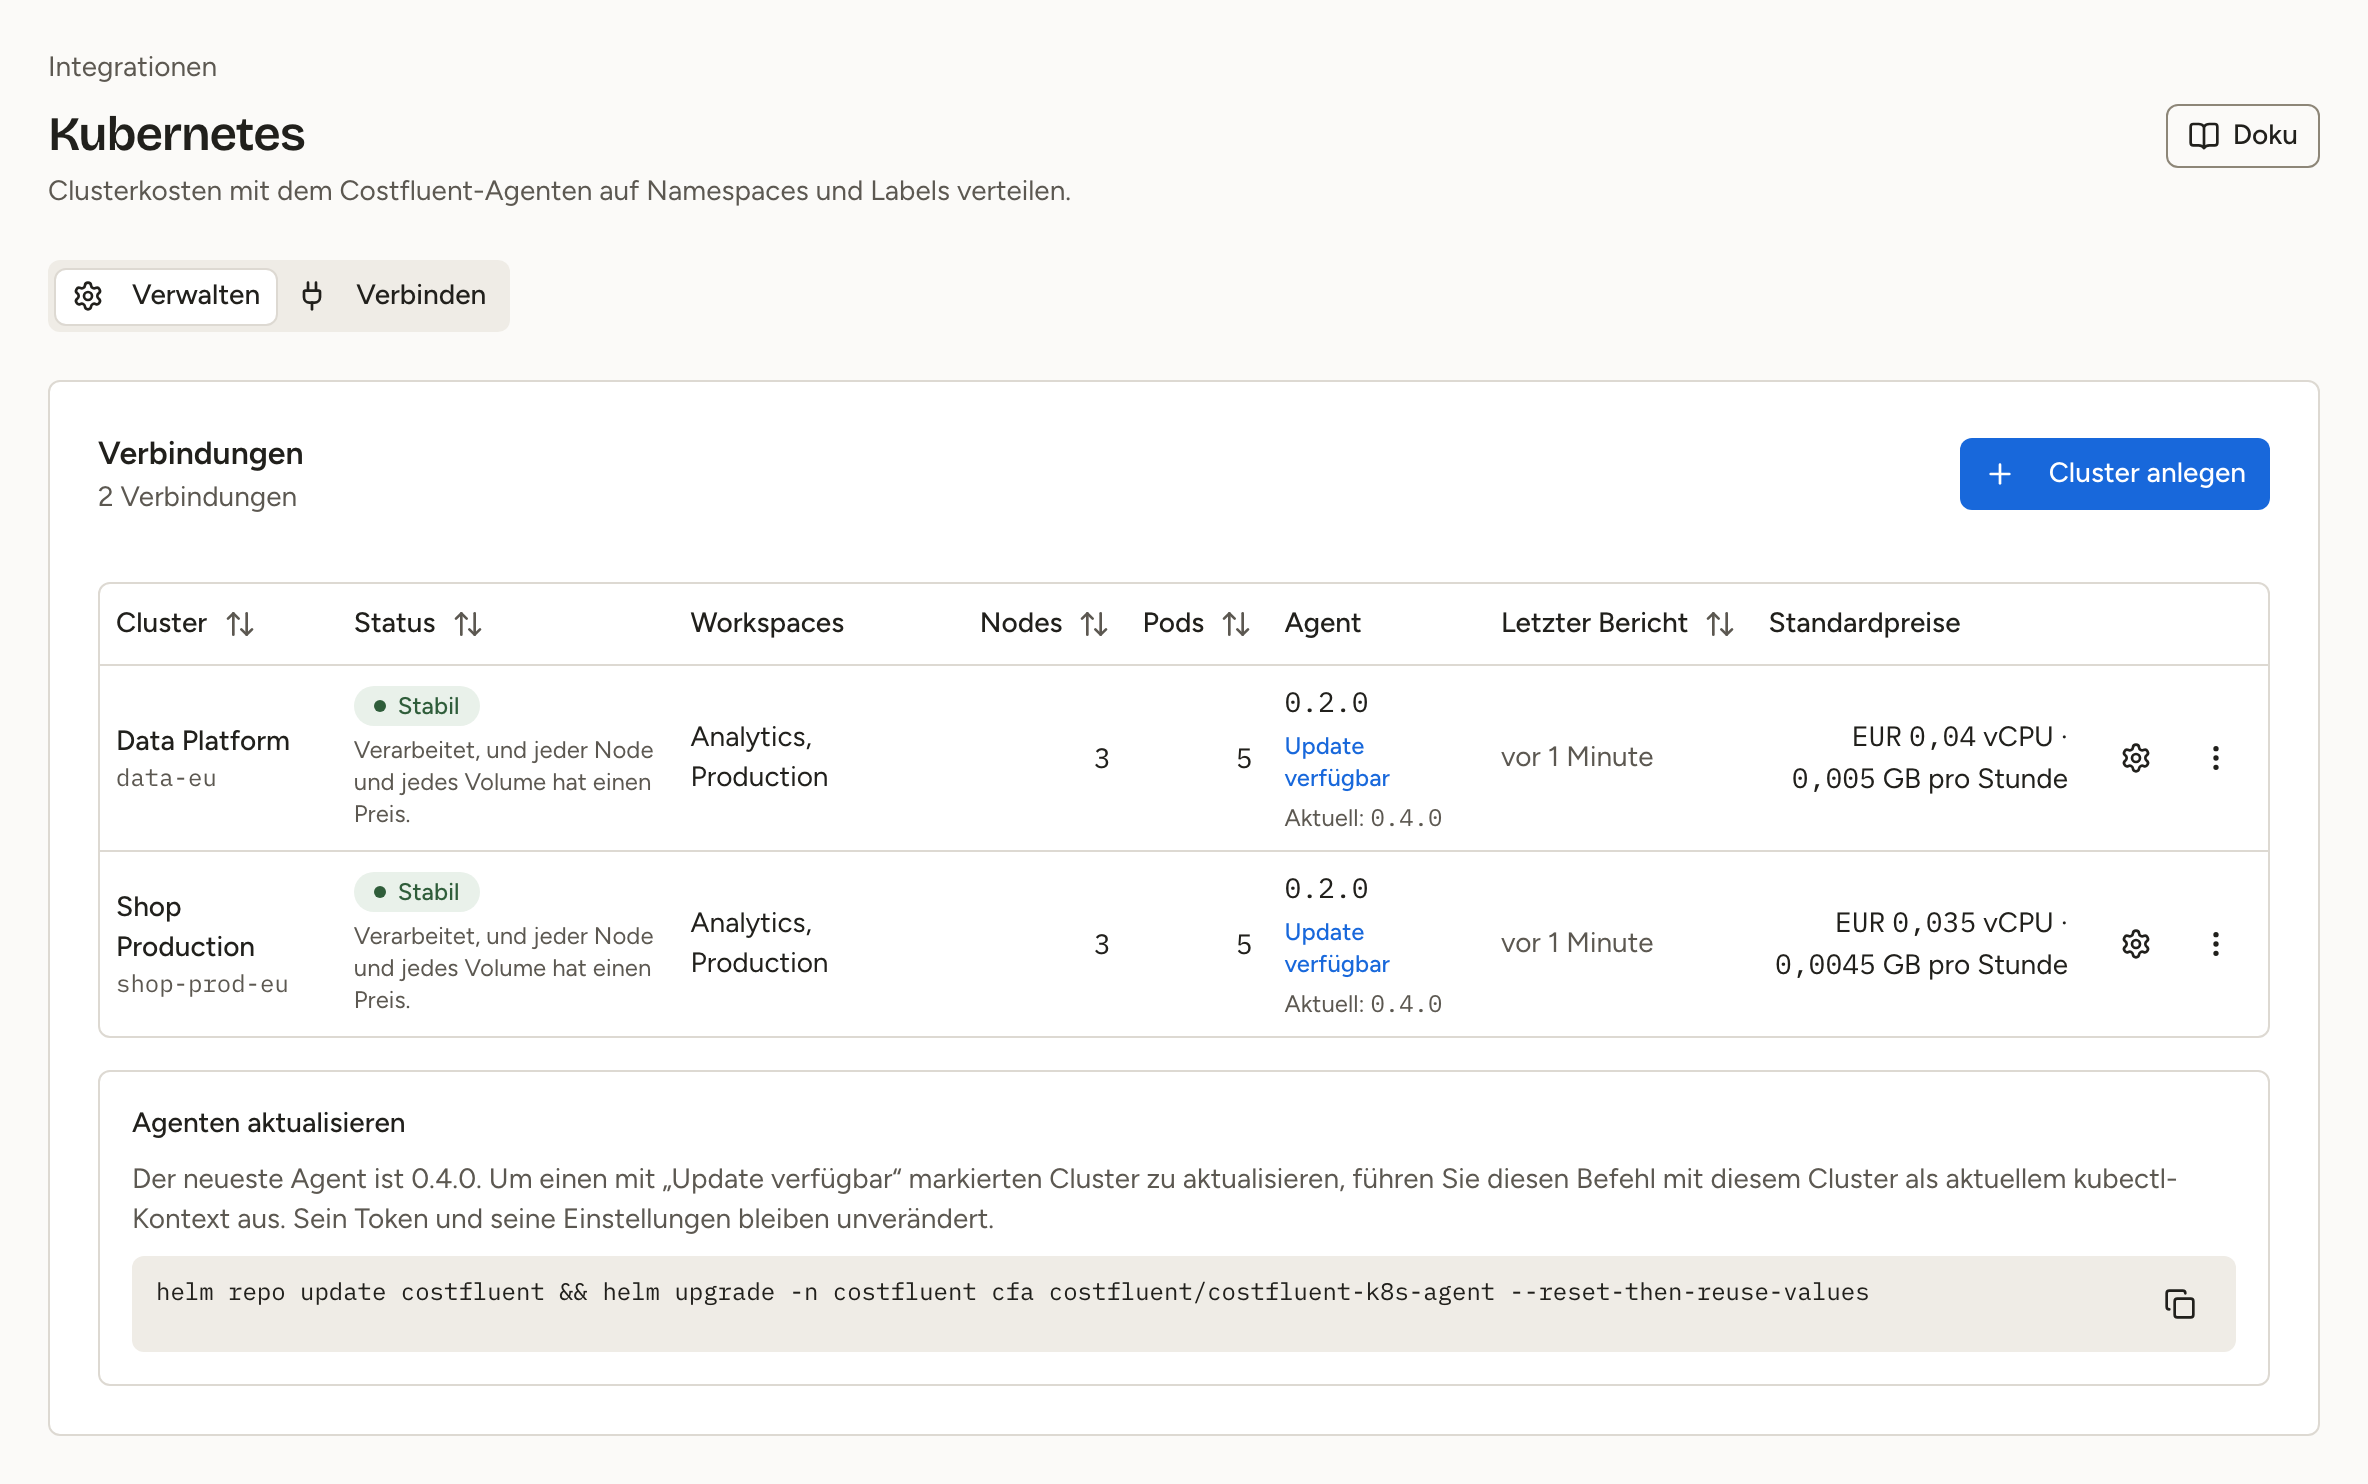
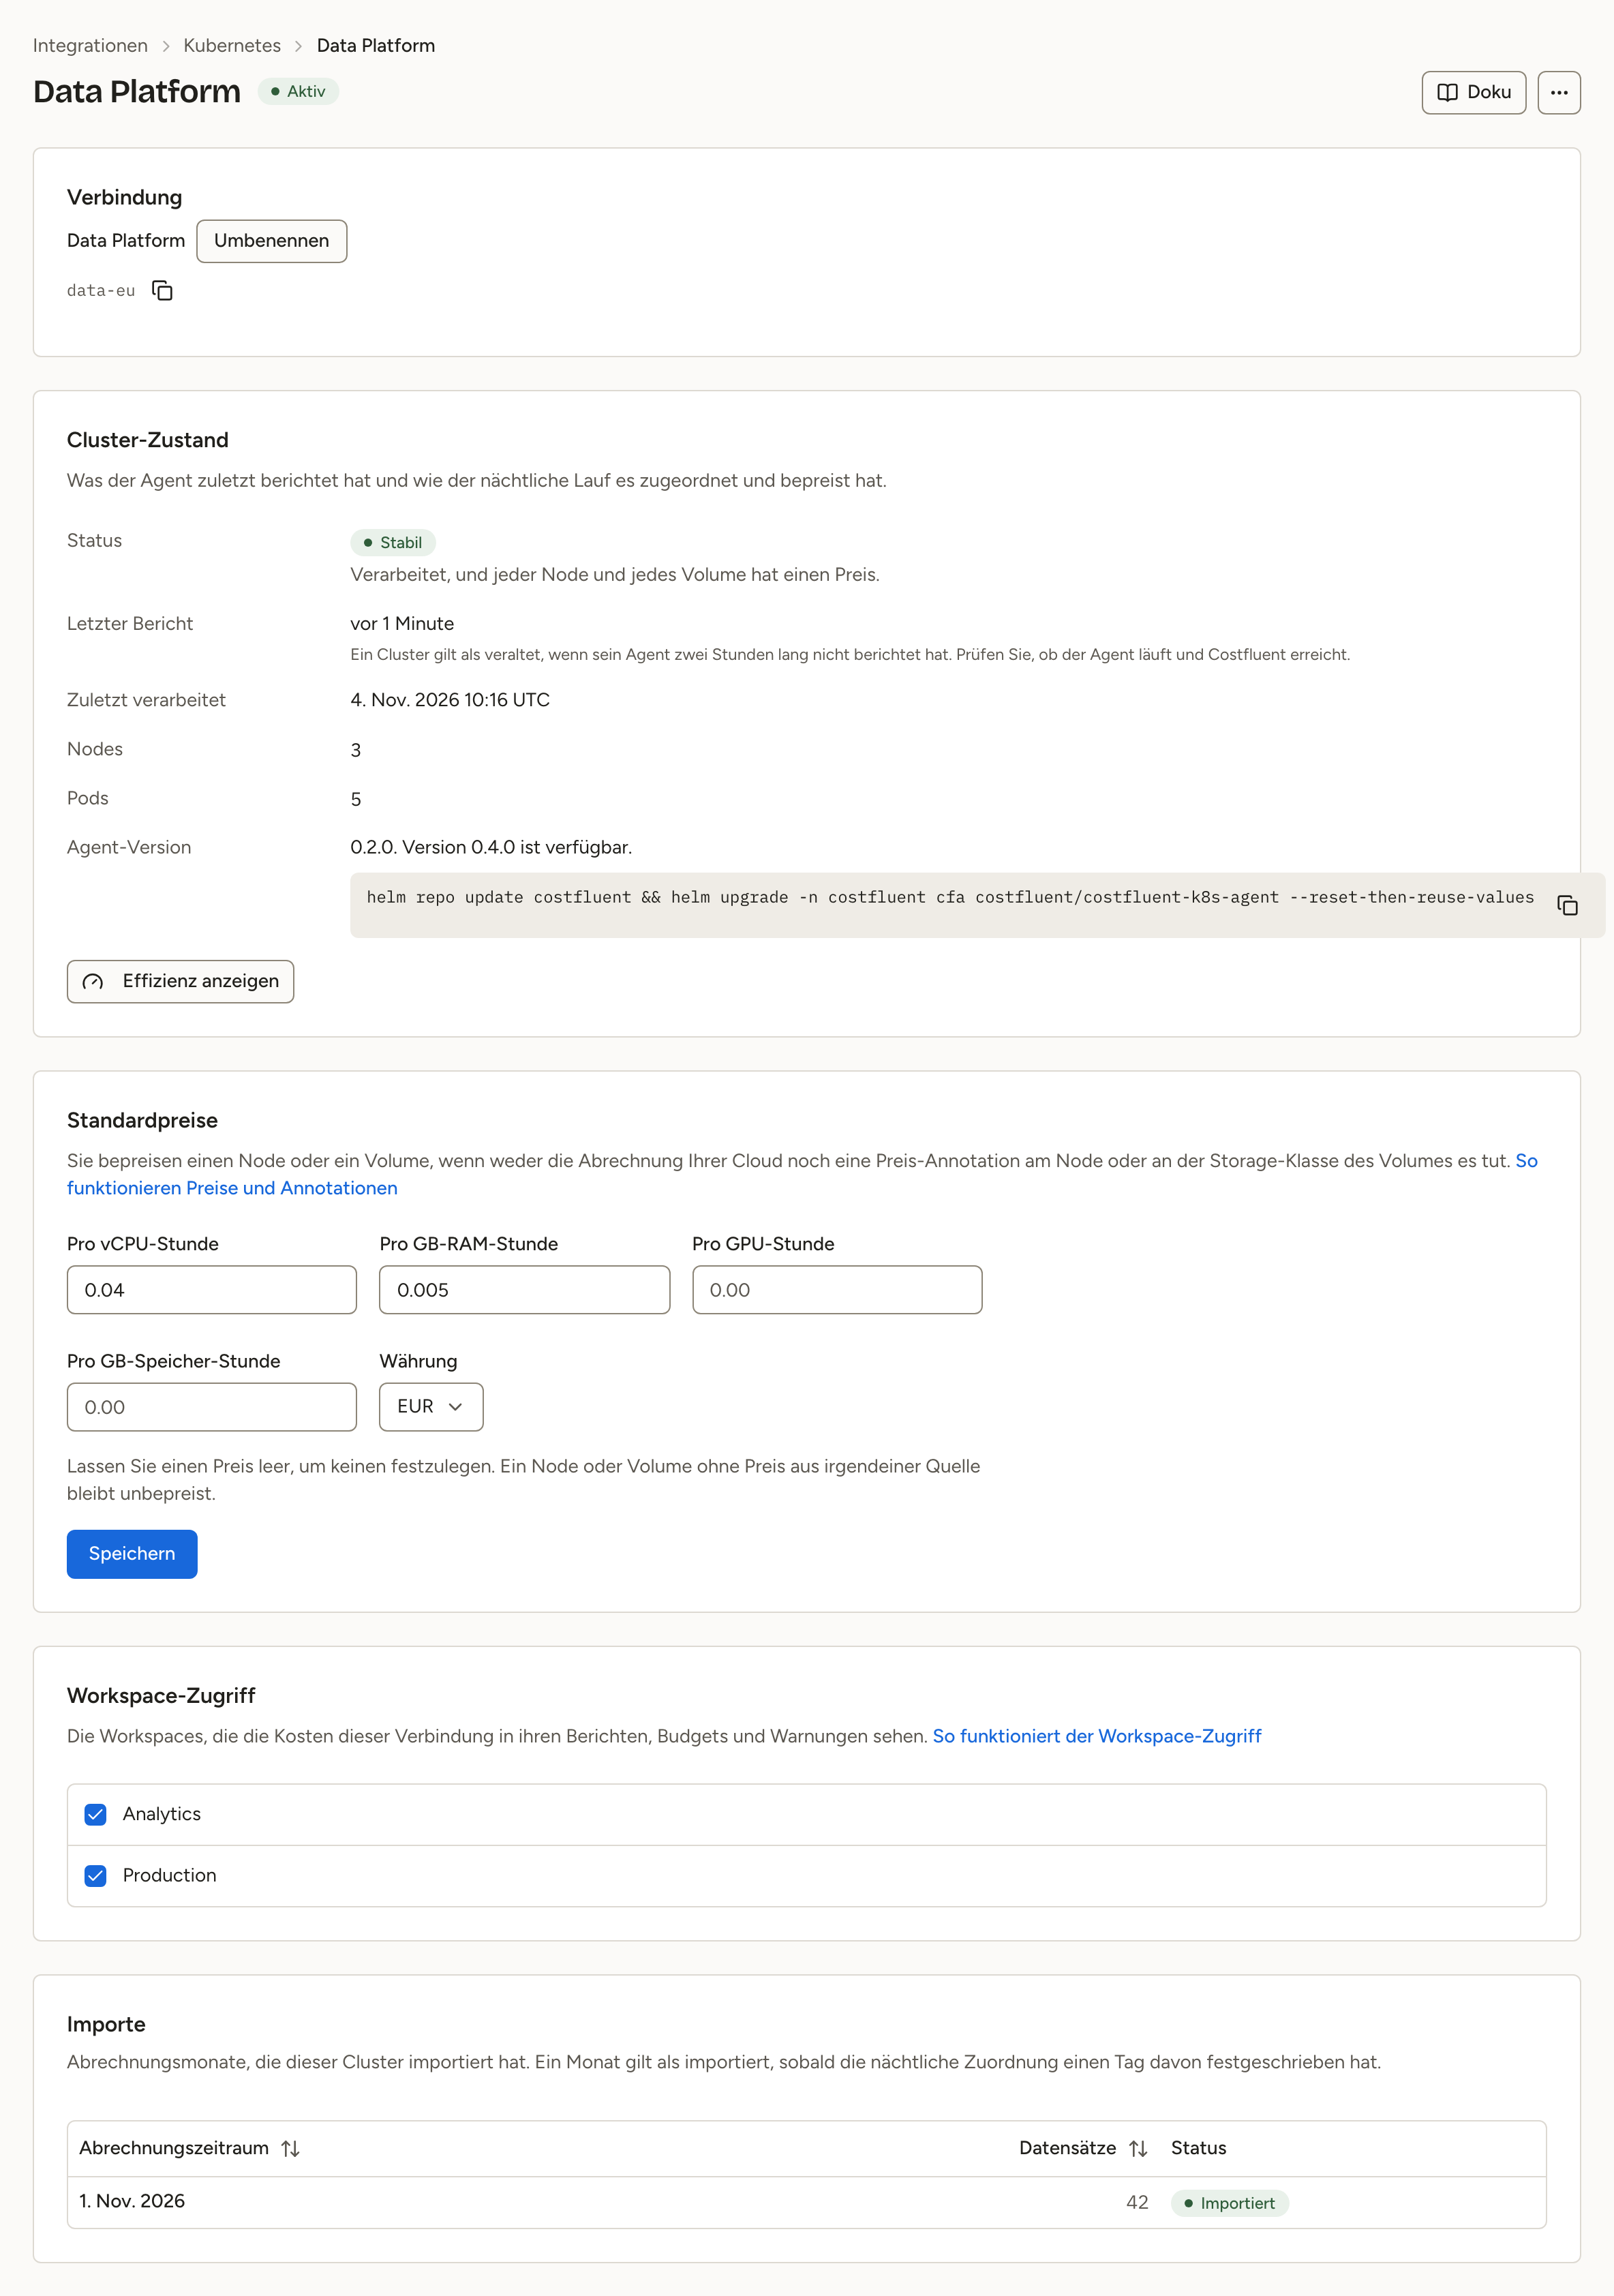
Die Kosten eines Clusters erscheinen nur in den Workspaces, die er speist, und ein neuer Cluster speist keinen. Im Tab Verwalten listet die Karte Verbindungen die Cluster, und ihre Spalte Workspaces nennt die Workspaces, die jeder Cluster speist; für einen Cluster, der keinen speist, warnt sie mit „Kein Workspace sieht seine Kosten“, einem Link auf die Seite des Clusters. Wählen Sie den Namen eines Clusters oder Verwalten in seiner Zeile, um seine Seite zu öffnen:
- Der Kopf zeigt den Namen des Clusters, seinen Verbindungsstatus und Doku und, für Eigentümer und integrationsverantwortliche Personen, ein Menü mit Neues Token und Verbindung entfernen.
- Verbindung zeigt den Namen des Clusters und seine Cluster-ID, mit Umbenennen für Eigentümer und integrationsverantwortliche Personen.
- Cluster-Zustand zeigt seinen Status und was er bedeutet, seinen letzten Bericht, seinen letzten Verarbeitungslauf, seine Nodes und Pods, seine Agent-Version mit dem Upgrade-Befehl, wenn eine neuere erschienen ist, und Nodes oder Volumes ohne Preis, mit Standardpreise festlegen, das Sie zu Standardpreise bringt. Der Status Ausstehend, Veraltet oder Warnung verlinkt Fehler beheben mit seinem Eintrag unter Fehlerbehebung, und Ausstehend zeigt den Befehl, der den Pod des Agenten auflistet. Solange der aktuelle Workspace den Cluster liest, öffnet Effizienz anzeigen die Kubernetes-Effizienz gefiltert auf ihn.
- Standardpreise enthält die Preise und die Währung des Clusters (On-Premises und eigene Raten).
- Workspace-Zugriff hat für jeden Workspace ein Kontrollkästchen: Haken Sie die an, die die Kosten des Clusters sehen sollen. Eigentümer sowie integrationsverantwortliche Personen, die diesen Workspace bearbeiten können, können es ändern. Workspaces, die Sie nicht sehen können, werden unter der Liste gezählt.
- Importe listet jeden Monat ab dem, in dem der Cluster angelegt wurde. Ein Monat gilt als importiert, sobald die nächtliche Zuordnung einen Tag davon festgeschrieben hat.
Jeder Cluster hat seinen eigenen Workspace-Zugriff, sodass Cluster einer Organisation verschiedene Workspaces speisen können.
Daten und Aktualität
Wie die Kosten berechnet werden
Die Tageskosten jedes Nodes werden in CPU, Speicher und, auf GPU-Nodes, GPU aufgeteilt. Die
Berechnung nutzt die Ressourcenanforderungen und die gemessene Nutzung der Container, um Kosten
auf Namespaces zu verteilen. Der verbleibende Teil der Node-Kosten sind Leerlaufkosten und
erscheint als Namespace __idle__, den Berichte und Filter als Ungenutzte Kapazität zeigen.
Der Preis eines Nodes kommt aus der ersten dieser Quellen, die einen hat:
- Der Compute-Nutzung, die eine AWS-, Azure- oder GCP-Verbindung Ihrer Organisation für die Maschine des Nodes abrechnet, einschließlich der mit ihr abgerechneten CPU-Credits und Lizenzen.
- Den Annotationen des Nodes selbst, unten beschrieben.
- Den Raten, die in Costfluent für den Cluster hinterlegt sind.
Datenübertragung, andere Dienste, die auf die Maschine abgerechnet werden, Gutschriften, Erstattungen, Korrekturen und Steuern gehören nicht zum Preis eines Nodes und bleiben in den eigenen Berichten der Cloud.
Ein Node, den keine davon bepreist, wird ausgelassen und am Cluster als unbepreist gezählt.
Die Kapazität eines GPU-Nodes, die GPU-Anforderungen seiner Pods und ihre Nutzung in GPU-Hours zählen
physische GPUs. Vom Preis eines Nodes aus seiner Cloud-Abrechnung entfallen 95 % auf seine GPUs. Ab
Version 0.4.0 liest der Agent jede GPU-Ressource, die ein Node anbietet, nvidia.com/gpu,
nvidia.com/gpu.shared, die nvidia.com/mig-*-Profile und amd.com/gpu, und die Labels, die GPU
Feature Discovery des NVIDIA GPU Operators am Node setzt (nvidia.com/mig.strategy,
nvidia.com/gpu.product, nvidia.com/gpu.count, nvidia.com/gpu.replicas und
nvidia.com/gpu.slices.gi):
- MIG, Single Strategy: Die Geräte erscheinen als
nvidia.com/gpu, und jedes ist sein Anteil an einer GPU, die so viele aufnimmt, wie ihre Rechen- und Speicher-Slices erlauben. Eine A100, geteilt in sieben1g.5gb-Geräte, ist eine GPU, und ein Pod, der ein Gerät anfordert, zahlt ein Siebtel; eine H100 nimmt vier1g.20gbauf, je ein Viertel. - MIG, Mixed Strategy: Ein Gerät
nvidia.com/mig-<n>g.<m>gbist der Anteil seinernRechen-Slices an einer GPU, von sieben auf einer A100, H100, H200 oder B200 und vier auf einer A30. Wo die Geräte eines Nodes mit ihrem Speicher mehr GPUs füllen als mit ihren Rechen-Slices, zahlen diejenigen, die mehr vom Speicher einer GPU belegen als von ihren Rechen-Slices, auch die Rechen-Slices, für die ihr Speicher keinen Platz lässt: Vier1g.20gbauf einer H100 zahlen je ein Viertel, wie in der Single Strategy, und sechzehn3g.40gbbelegen acht H100 zu je einer halben. Der Node zählt die GPUs, die sein Labelnvidia.com/gpu.countangibt, partitioniert oder nicht, nie mehr als die Geräte, die er anbietet, und mindestens die GPUs, die seine Geräte brauchen: Acht3g.40gbauf einem Node mit dem Label für acht H100 zählen acht GPUs, und was sie nicht partitionieren, ist Leerlauf. - Time-Slicing: Jedes Replikat, als
nvidia.com/gpuoder umbenannt alsnvidia.com/gpu.shared, ist einnvidia.com/gpu.replicas-tel einer GPU. amd.com/gpuzählt ganze GPUs.
Ein Node ohne diese Labels oder mit einer GPU, deren Slices Costfluent nicht kennt, zählt jedes Gerät
als GPU; geben Sie seine physischen GPUs mit einer Annotation an (unten). Ein älterer Agent meldet nur
nvidia.com/gpu, das wie bisher gezählt wird.
Ab Agent-Version 0.4.0 ist der Tag jedes Persistent Volumes eine eigene Zeile Storage, in
GiB-Hours seiner Kapazität, neben den Zeilen seiner Nodes und nie in ihnen. Der Preis eines Volumes
kommt aus der ersten dieser Quellen, die einen hat:
- Jede Nutzungszeile, die eine AWS-, Azure- oder GCP-Verbindung Ihrer Organisation für die Disk
des Volumes an diesem Tag abrechnet, einschließlich Kapazität, bereitgestellter IOPS und
Durchsatz: ein EBS-Volume über seine
vol--ID, wofür der AWS-Export Ressourcen-IDs enthalten muss; eine Azure Managed Disk über ihre Ressourcen-ID; eine GCP Persistent Disk über Projekt und Disk-Namen, die nur der detaillierte Abrechnungsexport enthält. Snapshots werden unter eigenen IDs abgerechnet und gehören nicht dazu. - Die Preis-Annotation seiner Storage-Klasse, unten beschrieben.
- Der Standardpreis für Speicher des Clusters.
Ein Volume, das keine davon bepreist, bleibt außen vor und wird beim Cluster als ohne Preis gezählt. Die Kosten eines Volumes gehen an die Pods, die seinen Claim eingebunden haben, nach den Sekunden, die jeder ihn eingebunden hatte; zwei Pods, die ihn gleichzeitig einbinden, teilen ihn. Was kein Pod eingebunden hat, bleibt beim Namespace des Claims, ohne Pod, weil der Claim für ihn angelegt wurde. Ein Volume, das kein Claim hält, etwa eines im Zustand Released oder Available, sind Leerlaufkosten. Das Puffer-Volume des Agenten ist ebenfalls ein Claim und erscheint als Speicherkosten im Namespace des Agenten.
Costfluent verarbeitet jeden Cluster einmal pro Nacht, um 04:30 UTC, für den Vortag. Kosten erscheinen deshalb am Morgen nach der Installation, während die Seite Kubernetes den neuesten Bericht schon nach wenigen Minuten zeigt. Ein Tag mit einem Node auf einer AWS-, Azure- oder GCP-Maschine oder einem Volume auf einer ihrer Disks wird zwei Tage später noch einmal verarbeitet, wenn die Abrechnung dieser Cloud für den Tag meist vollständig vorliegt, und seine Zahlen können sich dann noch ändern.
Gruppieren oder filtern Sie in Kostenberichten nach Cluster und Namespace, und nutzen Sie Pod-Labels als
Tags mit dem Namen k8s:label:<key>, Knoten-Labels als Tags mit dem Namen k8s:node_label:<key>,
Claim und Storage-Klasse eines Volumes als k8s:pvc und k8s:storage_class und Claim-Labels als
k8s:pvc_label:<key>. Die Kubernetes-Effizienz misst nur CPU und Arbeitsspeicher: Zeilen
Storage zählen weder zu ihren Kosten noch zu ihren Leerlaufkosten.
On-Premises und eigene Raten
Für Nodes ohne Cloud-Abrechnung, etwa in On-Premises- oder Bare-Metal-Clustern, öffnen Sie die Seite des Clusters, hinterlegen auf der Karte Standardpreise seine Preise Pro vCPU-Stunde, Pro GB-RAM-Stunde, Pro GPU-Stunde und Pro GB-Speicher-Stunde sowie deren Währung und wählen Speichern. Eigentümer und integrationsverantwortliche Personen können sie ändern; alle anderen sehen sie nur lesend. Um einzelne Nodes anders zu bepreisen, annotieren Sie sie:
Code
Annotationsraten gelten in der Währung des Clusters und haben Vorrang vor den Raten des Clusters. Ein Node mit irgendeiner Preis-Annotation wird nur aus seinen Annotationen bepreist: Eine Ressource ohne Annotation wird nicht aus den Raten des Clusters ergänzt.
Schreiben Sie jede Rate als einfache Dezimalzahl mit Punkt, etwa 0.021. Jeder andere Wert, etwa
0,021, 1,000.5, 1.5e3 oder eine negative Rate, lässt den Node ohne Preis und zählt ihn am
Cluster als unbepreist, statt ihn als andere Zahl zu lesen oder aus den Raten des Clusters zu
ergänzen. Eine leere Annotation zählt als keine Annotation.
Geben Sie für einen GPU-Node, dessen Labels nicht sagen, wie seine Geräte auf physische GPUs verteilt sind, an, wie viele er hat:
Code
Die Zahl ist eine ganze Zahl größer null, jeder andere Wert wird ignoriert. Diese Angabe hat Vorrang vor den Labels, gilt nur für einen Node, der eine GPU anbietet, und macht auf einem Node ohne die Labels jedes seiner Geräte zu einem gleichen Anteil dieser GPUs.
Ein Volume, dessen Disk keine Cloud abrechnet, etwa eines einer Ceph-, Longhorn- oder
local-path-Klasse, oder eine Dateifreigabe, wird über den Preis seiner Storage-Klasse je GB
Kapazität und Stunde bepreist, vor dem Standardpreis für Speicher des Clusters:
Code
Der Preis wird in der Währung des Clusters gelesen und wie die Node-Preise als einfache Dezimalzahl geschrieben; jeder andere Wert lässt die Volumes der Klasse ohne Preis.
Wie Summen einen Cluster zählen
Die Kosten eines Clusters sind die Kosten seiner Nodes, die bereits die Cloud-Verbindung meldet, die sie bezahlt. Eine Summe zählt diese Kosten deshalb einmal: Ein Kostenbericht oder eine Kostenwarnung über einen Workspace mit beiden Quellen lässt die Zeilen des Clusters weg, und Costfluent rechnet Kubernetes-Kosten nicht zu den erfassten Ausgaben.
Die Zeilen des Clusters zählen, wenn der Bericht nach Kubernetes fragt: mit einem Filter oder einer
Gruppierung nach Anbieter, Cluster, Namespace oder einem k8s:-Tag, oder mit einer
Public-API-Abfrage oder Kostenwarnung, die die Verbindung des Clusters nennt. Nach Namespace
gruppiert zeigt der Bericht die Verteilung; nach Anbieter gruppiert zeigt er den Cluster neben der
Cloud, die ihn bezahlt, sodass diese Summe die Nodes doppelt enthält.
Berichtsdimensionen
Was jede Gruppierungsdimension eines Kostenberichts für einen Cluster enthält und aus welchem Feld des Agentenberichts sie stammt. Die Zeilen eines Clusters zählen nur, wenn der Bericht nach Kubernetes fragt (Wie Summen einen Cluster zählen).
| Dimension | Bei Kubernetes | Quelle |
|---|---|---|
| Anbieter | kubernetes | Der Agent |
| Anbietername | Kubernetes | |
| Unterkonto | Nie gefüllt | |
| Dienst | CPU, Memory oder GPU: eine Zeile je Container und Kategorie; Storage: eine Zeile je Volume und Pod, der es einbindet | Die Berechnung (Wie die Kosten berechnet werden) |
| Region | Die Region des Knotens; keine bei einer Zeile Storage, da ein Volume keinen Knoten hat | nodes[].region |
| Ressource | Der Name des Pods; bei einer Leerlaufzeile der Name des Knotens; bei einer Zeile Storage der Name des Volumes | pods[].name, nodes[].name, volumes[].name |
| Kostenkategorie | Immer Usage | |
| Tag | k8s:label:<key> für jedes Pod- und Namespace-Label (ein Pod-Label gewinnt gegen ein Namespace-Label) sowie k8s:cluster, k8s:namespace, k8s:node, k8s:pod, k8s:container, k8s:controller_kind, k8s:controller und k8s:category auf jeder Zeile; k8s:node_label:<key> für jedes Label des Knotens der Zeile, auch auf seinen Leerlaufzeilen, außer den Labels für Hostname, Instanztyp, Region und Zone, die die Zeile schon angibt, und den veralteten beta-Aliasen; bei einer Zeile Storage kein k8s:node oder k8s:container, aber k8s:storage_class, k8s:pvc, außer das Volume ist ungenutzt, und k8s:pvc_label:<key> für jedes Label seines Claims | pods[].labels, pods[].namespace_labels, nodes[].labels, volumes[].storage_class, volumes[].claim_name, volumes[].claim_labels, die Felder der Zeile |
| Segment | Ihre Zuordnungsregeln | Segmente und Zuordnungsregeln |
| Cluster | Die Cluster-ID, mit der der Agent installiert wurde, nicht der Anzeigename | cluster_id |
| Namespace | Der Namespace des Pods oder des Claims eines Volumes; __idle__, angezeigt als Ungenutzte Kapazität, für die nicht zugeordneten Kosten eines Knotens und ein Volume, das kein Claim hält | pods[].namespace, volumes[].claim_namespace |
| Virtueller Tag | Ihre Regeln für virtuelle Tags | Virtuelle Tags |
Die k8s:-Schlüssel, die Costfluent auf jede Zeile schreibt, von k8s:cluster bis k8s:category,
sowie k8s:pvc und k8s:storage_class lassen sich wie jeder Tag gruppieren und filtern, machen eine
Zeile aber nicht getaggt: Für Getaggt ist eine Zeile eines Clusters nur getaggt, wenn sie einen
Tag k8s:label:<key>, k8s:node_label:<key> oder k8s:pvc_label:<key> trägt. Die Tag-Abdeckung lässt die Zeilen eines Clusters ganz aus
(Tags und Tag-Abdeckung).
Aktualisieren oder trennen
Den Agenten aktualisieren
Der Tab Verwalten zeigt die Agentenversion jedes Clusters. Ist ein Agent älter als der, den das
neueste Chart installiert, steht in seiner Zeile Update verfügbar mit der aktuellen Version, und
Agenten aktualisieren unter der Tabelle zeigt den Befehl, der ihn aktualisiert. Führen Sie ihn mit
diesem Cluster als aktuellem kubectl-Kontext aus; Token und Einstellungen bleiben, wie sie sind, und
Einstellungen, die das neue Chart hinzufügt, erhalten ihre Standardwerte. Er braucht Helm 3.14 oder
neuer, für --reset-then-reuse-values; ein älteres Helm bricht mit einem unbekannten Flag ab.
Auf das Chart festgelegt, das diese Seite beschreibt:
Code
Eine GitOps-Installation aktualisieren Sie stattdessen über ihr Manifest (GitOps mit Argo CD oder Flux).
Costfluent erfährt den neuesten Agenten innerhalb von sechs Stunden nach einer Chart-Veröffentlichung aus dem Chart-Repository. Solange es das Chart-Repository nicht lesen kann, wird kein Cluster markiert.
Das Token rotieren
Ein Cluster-Token läuft nicht ab. Es hört auf zu funktionieren, wenn es widerrufen wird und wenn das Konto, das es erstellt hat, deaktiviert oder gelöscht wird. Ersetzen Sie es immer dann, wenn es durchgesickert sein könnte, und bevor dieses Konto ausscheidet.
-
Wählen Sie im Tab Verwalten den Eintrag Neues Token im Zeilenmenü des Clusters oder im Menü auf der Seite des Clusters. Das angezeigte Token funktioniert neben dem alten, bis Sie das alte widerrufen.
-
Geben Sie es dem Agenten. Mit
agent.tokenaktualisieren Sie das Release mit dem neuen Wert; das Chart schreibt sein Secret neu und rollt den Agent-Pod aus:CodeMit
agent.secretersetzen Sie das Token in diesem Secret und starten den Agenten neu, denn er liest sein Token nur beim Start:Code -
Sobald das Log des Agenten einen sauberen Start zeigt, öffnen Sie Einstellungen, dann API-Token, und wählen Sie Token widerrufen in der Zeile des alten Tokens.
Trennen
Diese Befehle entfernen eine Helm-Installation; eine GitOps-Installation entfernen Sie über ihren Controller (GitOps mit Argo CD oder Flux).
Code
Der Cluster wird zwei Stunden später Veraltet, seine bisherigen Kosten bleiben in den
Kostenberichten. Entfernen Sie ihn mit Verbindung entfernen im Zeilenmenü im Tab Verwalten
oder im Menü auf seiner Seite und bestätigen Sie mit Entfernen im Dialog Verbindung entfernen,
der den Deinstallationsbefehl zeigt und die Workspaces nennt, die der Cluster speist. Das Entfernen eines Clusters löscht die auf seine Namespaces verteilten Kosten und entfernt
ihn aus allen Workspaces. Das kann nicht rückgängig gemacht werden. Ein Agent, der für einen
entfernten Cluster weiterläuft, wird mit 410 abgelehnt, und die Tokens des Clusters hören mit ihm
auf zu funktionieren.
Fehlerbehebung
Cluster-Status
| Status | Bedeutung |
|---|---|
| Ausstehend | Der Cluster wurde angelegt, und noch ist kein Bericht eingetroffen. Prüfen Sie, ob der Agent mit dem Token dieses Clusters installiert ist und sein Pod läuft. |
| Import läuft | Der Cluster hat berichtet, sein erster Tag ist noch nicht verarbeitet. |
| Stabil | Berichte kommen an und jeder Tag wird verarbeitet. |
| Veraltet | Seit zwei Stunden kein Bericht. Prüfen Sie, ob der Agent-Pod läuft und Costfluent erreicht. |
| Warnung | Einige Nodes oder Persistent Volumes haben keinen Preis, die Verarbeitung eines Tages ist fehlgeschlagen, oder ein Tag wurde zusammengefasst. Die Zeile unter dem Status, Letzter Verarbeitungslauf:, sagt, was davon. Ein Cluster, dessen Agent einige Nodes nicht lesen konnte, zeigt ebenfalls Warnung, und seine Zustandskarte sagt, auf wie vielen (Häufige Fehler). Ein Volume einer Klasse, die keine Cloud abrechnet, erhält einen Preis, sobald seine Storage-Klasse eine Preis-Annotation oder der Cluster einen Standardpreis für Speicher hat. |
Unter Einstellungen, Integrationen steht die Verbindung eines Clusters auf Ausstehend,
bis der erste nächtliche Lauf seine Kosten verarbeitet, danach auf Aktiv, mit diesem Lauf als
Letzte Synchronisierung; jeder spätere Lauf, der einen Tag verarbeitet, rückt sie vor. Ist sie
Aktiv und berichtet der Agent eines Clusters nicht mehr, wird das einen Tag nach seinem letzten
Bericht gemeldet und noch einmal nach drei Tagen, frühestens zwei Tage nach der ersten Meldung,
solange der Agent die nicht gesendeten Berichte noch vorhält (96 Stunden): per Hinweis in der App,
E-Mail, über die Kanäle Ihrer Organisation und den Webhook connection_stale, mit Link zur
Clusterseite. Ein Bericht hebt die Meldung auf. Schlägt ein nächtlicher Lauf fehl, während der Agent
berichtet, wird das nicht gemeldet; der Cluster zeigt Warnung mit dem Fehler.
Stabil, aber keine Kosten in Berichten
Ein Cluster kann Stabil sein, während die Berichte eines Workspace keine seiner Kosten zeigen:
- Der Cluster speist keinen Workspace oder nicht diesen. Die Spalte Workspaces im Tab Verwalten nennt die Workspaces, die er speist, und zeigt „Kein Workspace sieht seine Kosten“ für einen Cluster, der keinen speist. Haken Sie den Workspace unter Workspace-Zugriff auf der Seite des Clusters an (Festlegen, welche Workspaces einen Cluster sehen).
- Der Workspace hat den Cluster ausgeschaltet. Unter Einstellungen, dann Arbeitsbereich-Provider, ist der Schalter Aktiviert des Clusters aus; schalten Sie ihn ein (Verbindungen verwalten).
- Der Bericht fragt nicht nach Kubernetes. In einem Workspace, der auch die Cloud-Verbindung liest, die die Nodes des Clusters bezahlt, lässt eine Summe die Zeilen des Clusters weg, damit die Nodes einmal zählen. Filtern oder gruppieren Sie den Bericht nach Anbieter, Cluster oder Namespace, um sie zu sehen (Wie Summen einen Cluster zählen).
Häufige Fehler
Der Agent protokolliert jeden abgelehnten Upload mit dem Grund. Die häufigsten:
- 401, 403 oder „is not a cluster token“. Das Token ist falsch, widerrufen oder nicht das eigene Token dieses Clusters; ein Organisations-API-Token wird abgelehnt. Der Agent prüft sein Token beim Start und beendet sich mit diesem Grund, sodass der Pod neu startet, statt sich bereit zu melden; wird das Token später abgelehnt, sendet der Agent erst nach einem Neustart wieder. Die Berichte bleiben gepuffert: Ersetzen Sie das Token wie unter Das Token rotieren, um sie nachzuholen.
- „is not the cluster the API token belongs to“.
agent.clusterIDnennt einen anderen Cluster als den des Tokens. Entfernen Sieagent.clusterIDoder installieren Sie das Token jenes Clusters. - 400. Der Bericht wurde als ungültig abgelehnt, und das Protokoll nennt den Grund. Lautet er,
dass ein Bericht mehr Nodes oder Pods enthält als zulässig, ist der Cluster größer, als Costfluent
erfasst; wenden Sie sich an den Support. Lautet er, dass
window_endin der Zukunft liegt, geht die Uhr des Nodes mehr als fünf Minuten vor, und Agent-Versionen bis 0.2.1 verwerfen diesen Bericht: Korrigieren Sie die Zeitsynchronisierung (NTP) des Nodes. Lautet er, dasswindow_startälter ist als die Tage, die Costfluent noch verarbeitet, begann das Zeitfenster vor mehr als sechs Tagen. Da ein Agent Berichte höchstens 96 Stunden aufbewahrt, kommt das nur vor, wenn die Uhr des Nodes Tage nachgeht; der Agent verwirft diesen Bericht: Korrigieren Sie die Zeitsynchronisierung (NTP) des Nodes. Andernfalls aktualisieren Sie den Agenten. - 409. Ein anderer Agent meldet diesen Cluster bereits für ein überlappendes Zeitfenster: Betreiben Sie einen Agenten pro Cluster, jeden mit dem Token seines eigenen Clusters. Sagt das Log stattdessen, dass der Tag bereits 1.440 Berichte hält, ist der Agent an diesem Tag Hunderte Male neu gestartet: Finden Sie heraus, warum sein Pod neu startet. Der Agent verwirft den Bericht in beiden Fällen; ein Tag mit 1.440 Berichten wird mit denen verarbeitet, die er behält.
- 410. Der Cluster wurde in Costfluent gelöscht. Deinstallieren Sie den Agenten oder legen Sie den Cluster erneut an und installieren Sie sein neues Token.
- 413. Ein Bericht war zu groß. Agent-Versionen bis 0.2.1 warten und versuchen es erneut;
schränken Sie
agent.allowedLabelsein, wenn es anhält. - 429. Der Agent behält den Bericht und sendet ihn erneut. Sagt das Log, dass die Cluster der Organisation heute bereits 1 GiB komprimierte Berichte gesendet haben, wird der Bericht nach Mitternacht UTC angenommen, sofern der Puffer des Agenten ihn nicht vorher verwirft. Andernfalls war Costfluent mit anderen Berichten beschäftigt, und der Agent sendet ihn kurz darauf erneut.
- Keine Nutzung oder weniger Nodes, als der Cluster hat. Der Agent konnte einige Kubelets nicht
lesen. Einen Node, den er nicht lesen kann, lässt er mit seinen Pods aus dem Bericht weg, statt
sie als ungenutzt zu zählen, und ab Chart 0.4.0 meldet er, wie viele Nodes er nicht lesen konnte
und warum: Der Cluster wechselt auf Warnung, und seine Karte Cluster-Zustand sagt, auf wie
vielen seiner Nodes die Nutzung nicht lesbar ist, mit der Lösung für jeden Grund. Das Log des
Agenten nennt jeden Node und Grund als „kubelet scrape failed“
(
kubectl -n costfluent logs -l app.kubernetes.io/instance=cfa):tls: Die Kubelets liefern Zertifikate, die der Agent nicht prüfen kann, wie standardmäßig auf Talos, kubeadm und kind. Lassen Sie sie von der Cluster-CA signieren, die sichere Lösung, oder setzen Sieagent.disableKubeTLSverify=true(Kubelet-Zertifikate).unreachable: Der Agent fand keine Adresse für den Node oder konnte Port 10250 nicht erreichen, wie auf AKS, wo Kubelets unter ihrer Standardadresse oft nicht erreichbar sind. Setzen Sieagent.nodeAddressTypes=InternalIPund erlauben Sie Port 10250, wo ausgehender Verkehr standardmäßig gesperrt ist (Default-Deny-Egress).unauthorized: Das Kubelet oder der API-Server, der sein Token ausstellt, hat das Kubelet-Konto des Agenten abgelehnt. Prüfen Sie, ob seine ClusterRolegetaufnodes/metricsgewährt, ob der Agent das Token dieses Kontos erstellen darf und ob die Kubelets Tokens per Webhook authentifizieren.other: Das Log des Agenten nennt den Fehler.
- Pod Pending, oder die Installation bricht mit „no default StorageClass“ ab. Keine StorageClass
stellt den Volume-Claim des Agenten bereit, daher wird der Pod nie eingeplant und protokolliert
nichts; ab Chart 0.3.0 bricht die Installation ab, bevor sie etwas anlegt. Setzen Sie
persist.storageClassNameauf eine der Klassen des Clusters (kubectl get storageclass) oder installieren Sie mitpersist=null. Ein hängendes Release behält seinen Claim: Deinstallieren Sie es und löschen Sie den Claim (kubectl -n costfluent delete pvc -l app.kubernetes.io/instance=cfa), bevor Sie erneut installieren. - Die Installation bricht mit „context deadline exceeded“ oder einer Zeitüberschreitung ab. Die
Installation wartet, bis der Pod des Agenten bereit ist, standardmäßig fünf Minuten. Ein langsamer
Image-Pull kann länger dauern: Führen Sie denselben Befehl erneut aus, er setzt das Release dort
fort, wo es stehen blieb. Wird der Pod weiterhin nicht bereit, nennt
kubectl -n costfluent describe pod -l app.kubernetes.io/instance=cfaden Grund: ein Image, das sich nicht laden lässt, eine Ablehnung durch Pod Security oder ein Quota, oder ein Node-Selector, der auf keinen Node passt.